从 RNN、LSTM、GRU 到 ELMo:循环神经网络如何学会记忆上下文
刚学完机器学习时,我们接触的通常是这样的数据:给模型一套房子的面积、楼层、位置,让它预测房价;或者给模型一封邮件的若干特征,让它判断是不是垃圾邮件。
这些样本通常可以一条一条独立处理。但自然语言不一样,一个词是什么意思,经常要看它前后出现了什么。
例如下面两句话都有“苹果”:
- 我吃了一个苹果。
- 我买了一台苹果电脑。
只看“苹果”两个字,计算机无法判断它是水果还是公司。人类觉得很简单,是因为我们读到“吃”“电脑”时,会把上下文一起考虑进去。
RNN、LSTM 和 GRU 要解决的,就是怎样让神经网络拥有这种“读到后面,还能记得前面”的能力。ELMo 又向前走了一步:它让同一个词在不同上下文中得到不同的向量表示。
本文按照下面的顺序展开:
让信息沿句子传递"] --> B["LSTM
学会管理长期记忆"] B --> C["GRU
用更简单的结构做门控"] C --> D["ELMo
生成随上下文变化的词向量"]
文章中的实验都可以在配套 Notebook 中直接运行:
一、RNN:让神经网络一边阅读,一边做笔记
1. 普通神经网络缺少什么?
最普通的多层感知机(MLP)没有内置的时序记忆。如果把一句话拆成多个词,模型在处理当前词时,并不会自动知道前面出现过什么。
RNN(Recurrent Neural Network,循环神经网络)增加了一份“随身笔记”:
- 读当前词;
- 看一眼上一步留下的笔记;
- 把两者合起来,写出一份新笔记;
- 把新笔记传给下一个词。
这份笔记叫做隐藏状态,通常写成 $h_t$。其中的 $t$ 表示当前读到了第几个词。
图中虽然画了多个 RNN 方框,但它们其实是同一个单元反复使用。处理第一个词和处理第三十个词时,模型使用的是同一套参数。这叫做参数共享。
它有两个好处:
- 句子变长时,模型的参数数量不会跟着增长;
- 在句首学到的处理方法,也能用在句尾。
2. RNN 只保留一条公式就够了
RNN 最核心的计算只有一条:
$$ h_t=\tanh(W_xx_t+W_hh_{t-1}+b) $$
第一次看到这条公式,不必急着研究矩阵形状。先把它翻译成人话:
新笔记 = 处理一下(当前词 + 上一步笔记)
公式里的符号只是在把这句话写得更准确:
- $x_t$:当前读到的词;
- $h_{t-1}$:上一步留下的笔记;
- $W_x$、$W_h$:模型通过训练学到的处理方法;
- $\tanh$:把数值限制在一个稳定范围内;
- $h_t$:更新后的笔记。
理解到这里已经足够继续往下读。真正重要的是:当前状态不是只由当前词决定,它还带着前面的信息。
3. 这些隐藏状态可以怎么用?
RNN 每读一个词都会产生一份隐藏状态。不同任务会选择不同的使用方式。
| 任务 | 怎样使用隐藏状态 | 例子 |
|---|---|---|
| 给每个词分类 | 每个位置的状态各自分类 | 词性标注、命名实体识别 |
| 给整句话分类 | 使用最后一个状态统一分类 | 情感分析、垃圾邮件识别 |
| 预测下一个词 | 用当前状态预测后面的词 | 文本生成、输入法联想 |
例如做情感分析时,RNN 读完“这部电影一点也不好看”,最后一份笔记可以看成对整句话的压缩,再交给分类器判断正面还是负面。
4. Jupyter 实验:亲眼看看隐藏状态在变化
先准备两句话,每句话 5 个词,然后分别交给 PyTorch 中的 RNN、LSTM 和 GRU:
layers = {
    "RNN": nn.RNN(5, 6, batch_first=True),
    "LSTM": nn.LSTM(5, 6, batch_first=True),
    "GRU": nn.GRU(5, 6, batch_first=True),
}

for name, layer in layers.items():
    output, state = layer(embedded)
    print(name, output.shape)
运行后得到:
RNN : output=(2, 5, 6), h_n=(1, 2, 6)
LSTM: output=(2, 5, 6), h_n=(1, 2, 6), c_n=(1, 2, 6)
GRU : output=(2, 5, 6), h_n=(1, 2, 6)
暂时不用记住这些形状,只需要知道:
2表示一次输入了两句话;5表示每句话有 5 个词;6表示模型用 6 个数字保存当前状态;- LSTM 比另外两个模型多返回了一份
c_n,后面会解释它是什么。
把第一句话每个位置的隐藏状态画出来,可以看到模型每读一个词,6 个数都会发生变化:
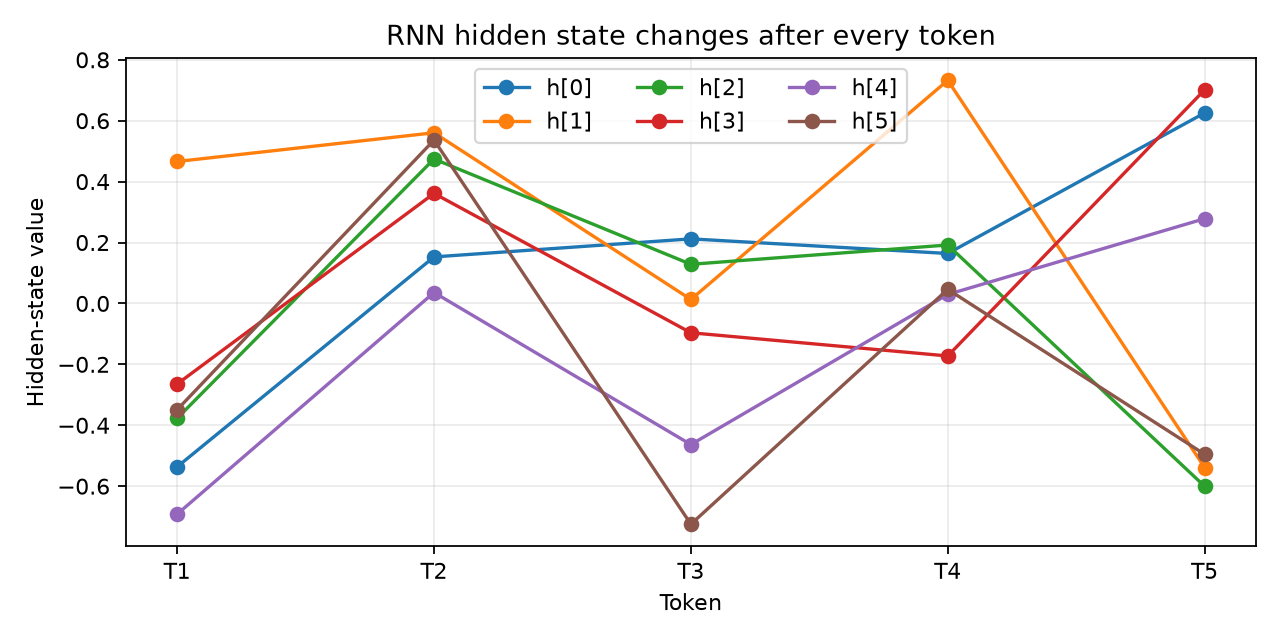
这个网络还没有训练,所以图中某条线并不代表固定的“情感”或“语法”。它只是直观地说明:RNN 读完一个词会更新状态,然后带着新状态继续阅读。
二、普通 RNN 为什么容易忘记很早以前的内容?
考虑下面这句话:
我去年在商场里反复比较了很久以后买下的那台笔记本电脑,现在仍然很好用。
读到“很好用”时,模型要知道被评价的是前面的“笔记本电脑”。中间隔得越远,模型越难保留这个信息。
可以把普通 RNN 想成一个不断改写的便签。每读一个词,它都要把“新词”和“旧便签”混在一起,重新写一张便签。改写次数太多以后,最早的内容就可能越来越模糊。
梯度消失,用一句话怎么理解?
模型训练时,最后的错误需要反向传回前面的每一步,告诉模型“当时应该怎样记”。这份纠错信号叫做梯度。
如果信号每向前传一步都只剩原来的八成,那么传 20 次以后就只剩一点点。距离太远时,开头几步几乎收不到纠错信号,模型自然很难学会“把这个信息一直记到最后”。这就是梯度消失最直观的含义。
反过来,如果信号每一步都被放大,也可能越来越大,形成梯度爆炸。梯度裁剪可以限制爆炸,但不能从根本上解决“记不久”的问题。
Jupyter 实验:第一个词还能收到多少学习信号?
Notebook 中放入一个 40 个词的序列,再让最后的分类结果对每个位置求梯度。这个过程由 PyTorch 自动完成,不需要我们手算微分。
embedded = model.embedding(sequence).detach().requires_grad_()
score = model.forward_from_embeddings(embedded)[0, 1]
score.backward()

gradient = embedded.grad.norm(dim=2)[0]
结果如下:
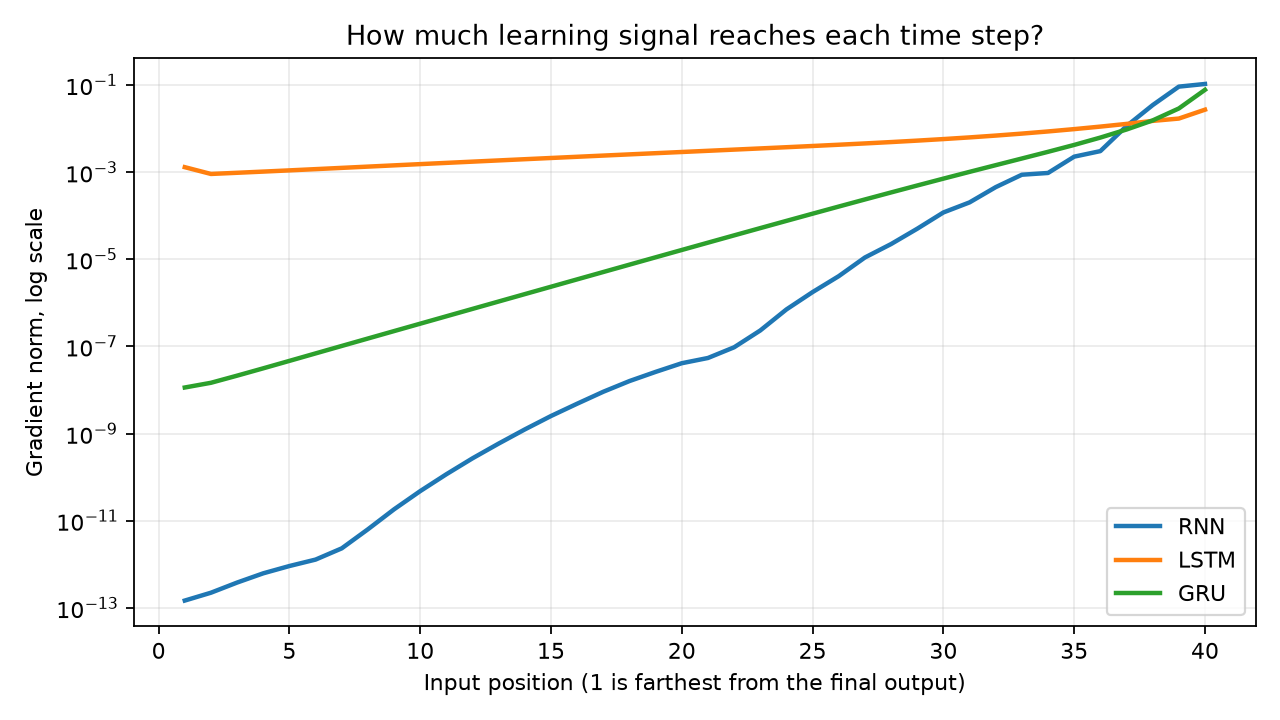
横轴越靠左,表示这个词离最终输出越远。纵轴使用对数刻度,每差一大格往往就是十倍甚至百倍的差距。
在这次固定初始化中:
- RNN 传到第一个词的信号已经接近 0;
- GRU 比 RNN 保留得更多;
- LSTM 的远距离信号最平稳。
这不代表任何情况下 LSTM 都一定最好。它说明的是:门控结构为长期信息提供了一条更容易通过的道路。 接下来就看看这条道路是怎么设计的。
三、LSTM:像管理笔记本一样管理长期记忆
LSTM 的全称是 Long Short-Term Memory,中文通常译为长短期记忆网络。它仍然从左到右逐步处理序列,外表和 RNN 很像,主要变化发生在单元内部。
普通 RNN 只有一份隐藏状态。LSTM 增加了一条专门保存长期信息的细胞状态:
- 隐藏状态 $h$:像当前放在桌面上的内容,对外提供输出;
- 细胞状态 $c$:像一本持续向后传递的笔记本,保存更长期的信息。
为了管理这本笔记,LSTM 设计了三个“门”。门并不是物理零件,而是一组 0 到 1 之间的数字,用来控制信息通过多少。
1. 遗忘门:旧内容还要不要?
遗忘门回答的是:
上一步笔记中的哪些内容应该继续保留?
例如模型正在阅读一段人物介绍,原来讨论的是“张三”,后来话题转到了“李四”。这时,与旧人物相关的一些信息就可以逐渐忘掉。
遗忘门不是一个总开关,而是可以分别控制每个维度。例如:
[0.95, 0.10, 0.72, ...]
可以粗略理解为:第一类信息保留 95%,第二类只保留 10%,第三类保留 72%。模型不需要把整份记忆一起清空,而是可以有选择地遗忘。
2. 输入门:新内容要写多少?
输入门回答的是:
当前看到的新信息,有多少值得写进长期笔记?
模型会先整理出一份“候选新内容”,再由输入门决定每一部分写入多少。路过的修饰词可能只写一点,新的主语、否定词或关键实体则可能写得更多。
所以 LSTM 更新长期记忆的过程,用一句话就能概括:
新长期记忆 = 保留下来的旧内容 + 筛选后写入的新内容
这就是整套 LSTM 中最值得记住的逻辑。
3. 输出门:现在需要拿出什么?
笔记本中可以保存很多内容,但当前任务不一定全部需要。
输出门负责从长期记忆中挑选当前要展示的部分,形成隐藏状态 $h$。例如模型可能同时记得人物、时间、地点和情感,但在判断情感时,更需要把与态度相关的信息提供给分类器。
可以把三个门连起来记:
遗忘门:擦掉什么
输入门:写入什么
输出门:拿出什么
4. 为什么说门是“向量”?
假设细胞状态由 128 个数字组成,那么遗忘门、输入门和输出门也各有 128 个数字。每一个数字都在 0 到 1 之间,分别控制对应的那一维信息。
这和我们之后会接触的基础 Attention 示意有所不同:
- LSTM 门控更像在问:“这份状态的每个维度保留多少?”
- Attention 更像在问:“这么多个词的位置中,我现在更应该看谁?”
现代 Attention 还有多头等更复杂的设计,但对于初学阶段,先记住“门控主要筛选状态维度,Attention 主要选择位置”就够了。
5. 遗忘门和输入门为什么互不补偿?
LSTM 的遗忘门和输入门是独立判断的,并不要求一个增加时另一个必须减少。因此某一维可能出现四种情况:
| 旧内容 | 新内容 | 直观含义 |
|---|---|---|
| 保留多 | 写入少 | 主要沿用过去 |
| 保留少 | 写入多 | 主要换成新信息 |
| 都少 | 这一维暂时几乎不保存信息 | |
| 都多 | 保留旧内容的同时继续补充 |
独立控制让 LSTM 很灵活,但也使它的结构和参数比较多。后面的 GRU 会把其中一部分控制合并起来。
6. LSTM 为什么更容易记得久?
关键不在于它“永远不会忘”,而在于它给长期记忆开辟了一条更平稳的通道。只要遗忘门判断某段信息仍然重要,就可以让它在细胞状态中继续向后传递,不必每一步都把所有内容彻底重算。
这也是 LSTM 能缓解长期依赖问题的根本原因。
至于输入是 256 维还是 128 维、输出要不要再做投影,都属于工程上的尺寸调整。它们不会改变“擦除、写入、输出”这套核心逻辑,初学时不用在这里停留太久。
四、GRU:用两个门完成更紧凑的记忆管理
GRU(Gated Recurrent Unit,门控循环单元)可以看成对 LSTM 的简化。
LSTM 同时维护细胞状态和隐藏状态,GRU 则只保留一份状态;LSTM 有三个门,GRU 主要使用两个门:
- 重置门:生成新内容时,要参考多少过去的信息;
- 更新门:最后要保留多少旧状态、采用多少新状态。
1. 重置门:需不需要参考过去?
当重置门接近 0 时,GRU 在准备新状态时会较少参考过去,更像重新开始;当它接近 1 时,就会充分利用旧信息。
例如句子进入一个全新话题时,减少对过去状态的依赖可能更合适。
2. 更新门:旧状态和新状态按比例混合
GRU 最有特点的地方,是旧状态与候选新状态使用互补比例。
如果某一维决定保留 80% 的旧信息,那么新信息就使用剩下的 20%。可以把它想成调果汁:杯子的总容量固定,旧果汁多一些,新果汁就只能少一些。
这与 LSTM 的遗忘门、输入门彼此独立不同。GRU 的做法更紧凑,也避免了同一维中“旧的和新的都大量写入”这种情况。
有些教材把更新门定义成“新信息比例”,另一些教材把它定义成“旧信息比例”,所以公式中两边可能刚好对调。遇到这种情况不用怀疑自己,只要先看作者如何定义更新门即可。
3. LSTM 和 GRU 怎么选?
| 对比项 | LSTM | GRU |
|---|---|---|
| 状态 | 长期状态和隐藏状态两份 | 只有一份状态 |
| 门 | 遗忘、输入、输出三个门 | 重置、更新两个门 |
| 新旧信息 | 分别独立控制 | 使用互补比例 |
| 参数量 | 通常更多 | 通常更少 |
| 直观特点 | 控制更细 | 结构更紧凑 |
GRU 通常参数更少、训练更快,在很多任务上能获得和 LSTM 接近的效果。但不存在“GRU 一定更好”或者“LSTM 一定更准确”的规则,真正的选择仍然要靠实验。
4. Jupyter 实验:让模型记住 40 步以前的第一个词
为了观察长期记忆,我们设计一个很简单的任务。每条序列有 40 个词:第一个词是“红”或“蓝”,后面 39 个都是无关词。
红  无关词  无关词  ……  无关词
蓝  无关词  无关词  ……  无关词
模型只能根据最后的状态回答:第一个词究竟是什么?
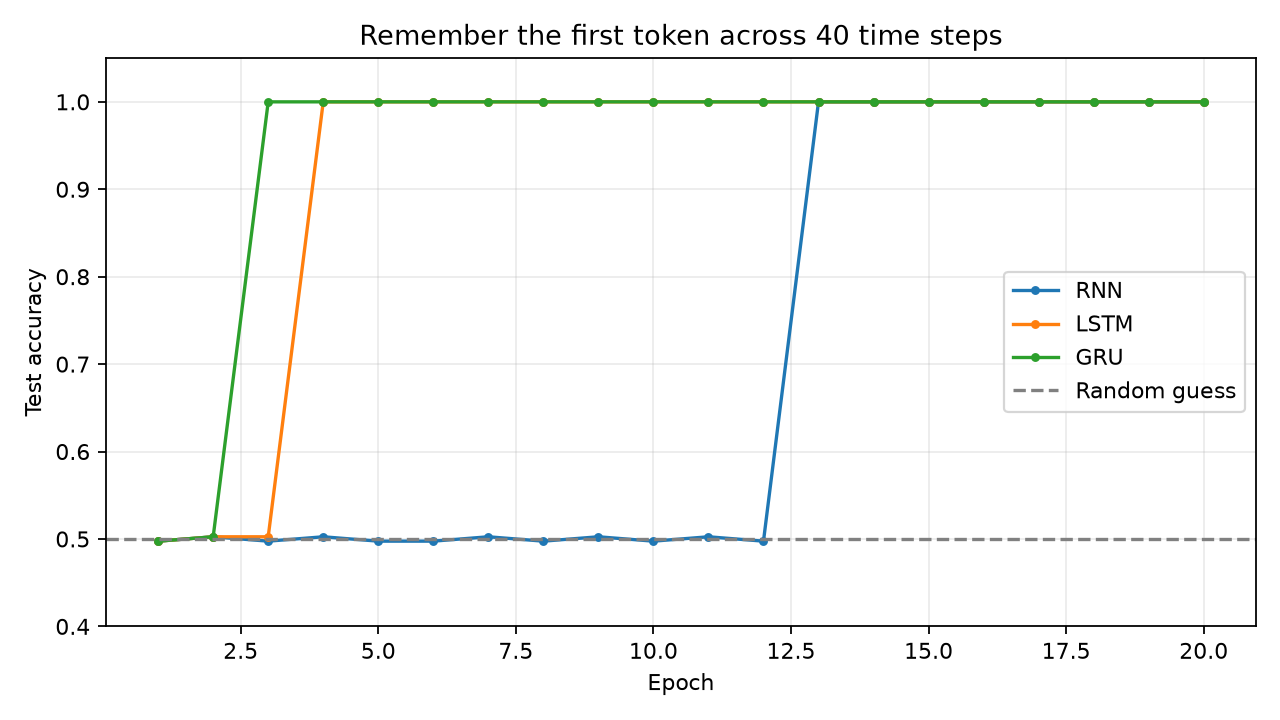
50% 左右相当于随机猜测。在这次固定随机种子下:
- LSTM 和 GRU 很快学会了任务;
- 普通 RNN 在随机猜测附近停留了更久,到后面才突然学会。
这与前面的梯度图能够对应起来:门控模型更容易把第一个词的信息保留到最后,也更容易把最后的纠错信号传回开头。
不过,这只是帮助理解的教学实验。换一个随机种子、增加干扰词或改变隐藏层大小,曲线都可能变化。它能说明门控结构的优势,但不能作为正式的模型排名。
五、ELMo:让“苹果”在不同句子里变成不同向量
RNN、LSTM 和 GRU 解决的是怎样处理序列。ELMo 则把循环网络产生的状态拿来表示词,从而解决静态词向量的一项重要缺陷。
1. 静态词向量为什么不够?
Word2Vec、GloVe 等方法会在词表中为每个词保存一个固定向量。训练结束以后,无论“苹果”出现在哪句话中,查到的都是同一行数字。
这相当于把一个词的多种含义混合在一起:
我吃了一个苹果       → 苹果是水果
苹果发布了一台电脑   → 苹果是公司
人类会根据上下文自动切换含义,静态词向量却做不到。代词也有类似问题:“他”到底指谁,只看这个词本身无法判断。
2. ELMo 的核心想法
ELMo 的想法可以用一句话概括:
词表中查到的向量只作为输入,真正交给下游任务的,是语言模型读完上下文以后产生的状态。
这样一来,同一个“苹果”经过不同上下文的影响,就会得到不同表示。这种表示叫做上下文化词表示,也常被通俗地称为动态词向量。
3. 为什么要使用双向 LSTM?
只从左向右读时,模型在处理当前词时只能看到前文。但理解一个词有时也需要后文。
例如看到“苹果发布”时,后面的“电脑”能帮助模型确认这里说的是公司。因此标准 ELMo 使用两层双向 LSTM:
- 前向 LSTM 从左向右读,利用左侧内容;
- 反向 LSTM 从右向左读,利用右侧内容。
得到初始词表示"] --> F1["第 1 层前向 LSTM →"] A --> B1["第 1 层反向 LSTM ←"] F1 --> F2["第 2 层前向 LSTM →"] B1 --> B2["第 2 层反向 LSTM ←"] F2 --> C["上下文化词表示"] B2 --> C
标准 ELMo 的最底层使用字符级 CNN。初学时可以先把它理解成“根据词的字符组成得到初始向量”,重点仍然是后面的双向 LSTM。
4. 训练时为什么不能提前合并两个方向?
前向语言模型做的事情是“根据前文猜下一个词”:
a, b       → 猜 c
a, b, c    → 猜 d
反向语言模型正好相反,它根据后文猜前一个词:
e          → 猜 d
d, e       → 猜 c
两个方向可以一起训练,但在预测目标词时不能提前合并信息。
例如用 a, b 猜 c,如果同时拿到从右向左读出的状态,这份状态很可能已经看过 c。模型就像考试时提前看到了答案,这叫做信息泄漏。
所以要区分两个阶段:
训练语言模型:两个方向各自遵守预测方向,不能偷看答案
用于下游任务:整句话已经给出,可以合并两个方向的表示
5. ELMo 为什么还要组合不同层?
双向 LSTM 的不同层往往会学到不同层次的信息。较低层可能更关注词形和句法,较高层可能包含更多语义。
情感分析、问答、序列标注需要的信息并不完全相同,因此 ELMo 不强迫所有任务只使用最后一层。它让每个下游任务自己学习:输入层、第一层和第二层分别应该占多大比例。
可以把它理解成调音台:不同任务会把不同层的音量调高或调低,再组合成最终表示。
6. Jupyter 实验:训练一个迷你版动态词向量
Notebook 使用 16 个短句训练了一个很小的双向语言模型。语料中既有水果含义的“苹果”:
我 喜欢 吃 苹果 很 甜
今天 买 的 苹果 很 甜
也有公司含义的“苹果”:
我 使用 苹果 电脑 工作
苹果 公司 发布 新 手机
如果只是从词嵌入表中查找,“苹果”无论出现在哪里都得到同一行数字,两个向量完全相同。
经过前向和反向 LSTM 编码后,同一个词会受到左右上下文影响,于是得到不同向量:
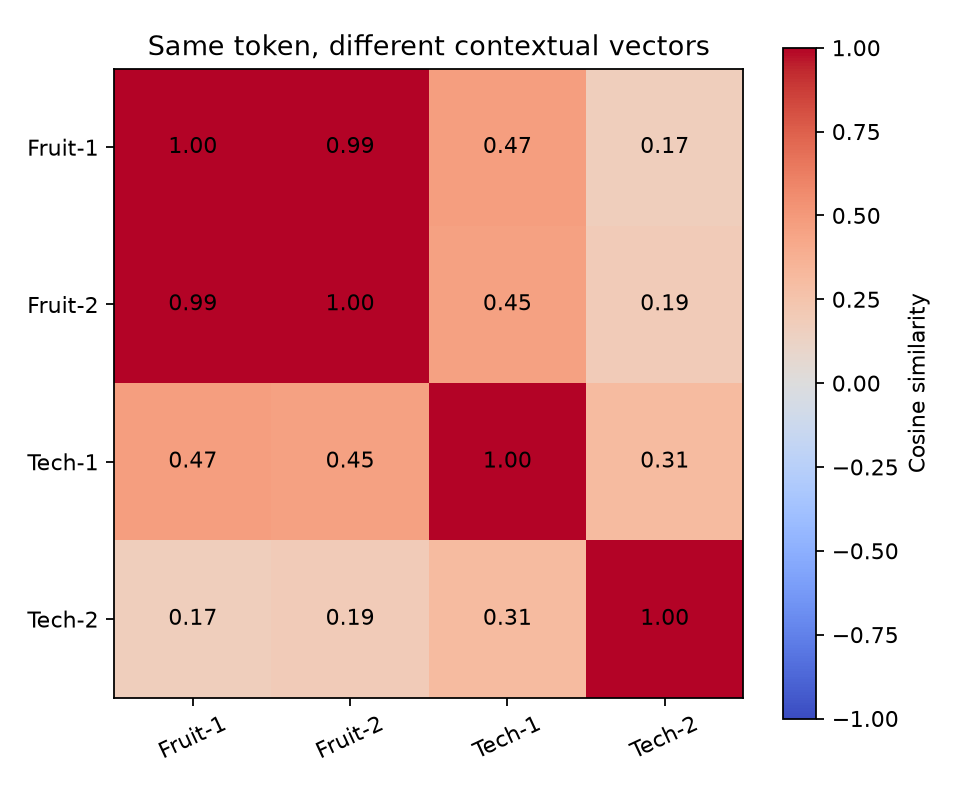
图中每一格表示两个“苹果”向量有多相似。对角线都是同一个向量与自己比较,所以等于 1;其他位置则会随句子变化。
这个实验的语料非常小,不能把具体数值当成真正的语义评测,更不能据此判断模型已经准确学会了水果和公司的概念。它只验证一个核心现象:
静态词向量只由“这个词是谁”决定,动态词向量还由“这个词出现在什么上下文中”决定。
7. 为什么说 ELMo 有些“生不逢时”?
Transformer 在 2017 年提出,ELMo、GPT 和 BERT 则先后在 2018 年出现。ELMo 很早就证明了上下文化表示和大规模预训练的价值,是自然语言处理发展中的重要一步。
但 ELMo 的主体仍然是 LSTM,必须一个时间步接一个时间步地计算,不容易大规模并行。基于 Transformer 的 GPT 和 BERT 更适合并行训练,也更容易直接连接距离很远的词,后来逐渐成为预训练语言模型的主流。
所以说 ELMo“生不逢时”,不是说它不重要,而是它刚展示出动态词向量的价值,底层架构就迎来了更适合大规模预训练的 Transformer。
六、把四个模型放在一起理解
| 模型 | 它解决了什么问题 | 最值得记住的做法 | 主要局限 |
|---|---|---|---|
| RNN | 让模型利用前面的信息 | 把隐藏状态传给下一步 | 长序列中容易忘记早期内容 |
| LSTM | 更好地学习长期依赖 | 用细胞状态和三个门管理记忆 | 参数较多,仍要顺序计算 |
| GRU | 简化门控循环网络 | 用两个门和一份状态完成控制 | 控制方式比 LSTM 更紧凑 |
| ELMo | 让词向量随上下文变化 | 使用双向 LSTM 生成词表示 | LSTM 主体不容易并行 |
把它们连起来看,演进逻辑非常清楚:
- 普通 MLP 没有时序记忆,于是 RNN 把上一步状态传给下一步;
- RNN 容易忘记很早的信息,于是 LSTM 增加长期状态和门控;
- LSTM 结构比较复杂,于是 GRU 用两个门进行简化;
- 静态词向量无法区分多义词,于是 ELMo 用双向 LSTM 生成动态表示;
- 循环网络不容易并行,于是预训练语言模型的主线继续转向 Transformer。
七、初学阶段最后记住这些就够了
- RNN 的本质,是一边读当前输入,一边把过去的隐藏状态带过来。
- 普通 RNN 不是完全没有记忆,而是距离太远时很难学会应该保留什么。
- LSTM 的核心不是一堆公式,而是“忘掉什么、写入什么、输出什么”。
- LSTM 的门是 0 到 1 的向量,可以分别控制状态的每一个维度。
- GRU 把结构做得更紧凑,用互补比例混合旧状态和候选新状态。
- ELMo 的关键贡献,是让同一个词根据上下文获得不同表示。
- 实验曲线可以帮助理解现象,但一次小实验不能证明某个模型永远更好。
不必急着背四套公式。后面真正使用 PyTorch 搭模型时,再回头看每个参数和张量形状,理解成本会低很多。